Réponse courte
Pour transformer des données brutes en dashboard opérationnel, partez de la décision à prendre et fixez le grain de chaque mesure. Conservez ensuite une copie brute traçable, normalisez les identités et les dates, appliquez les règles métier dans une couche distincte, testez la fraîcheur et la correction, puis publiez des indicateurs dont chaque valeur peut être rapprochée de sa source.
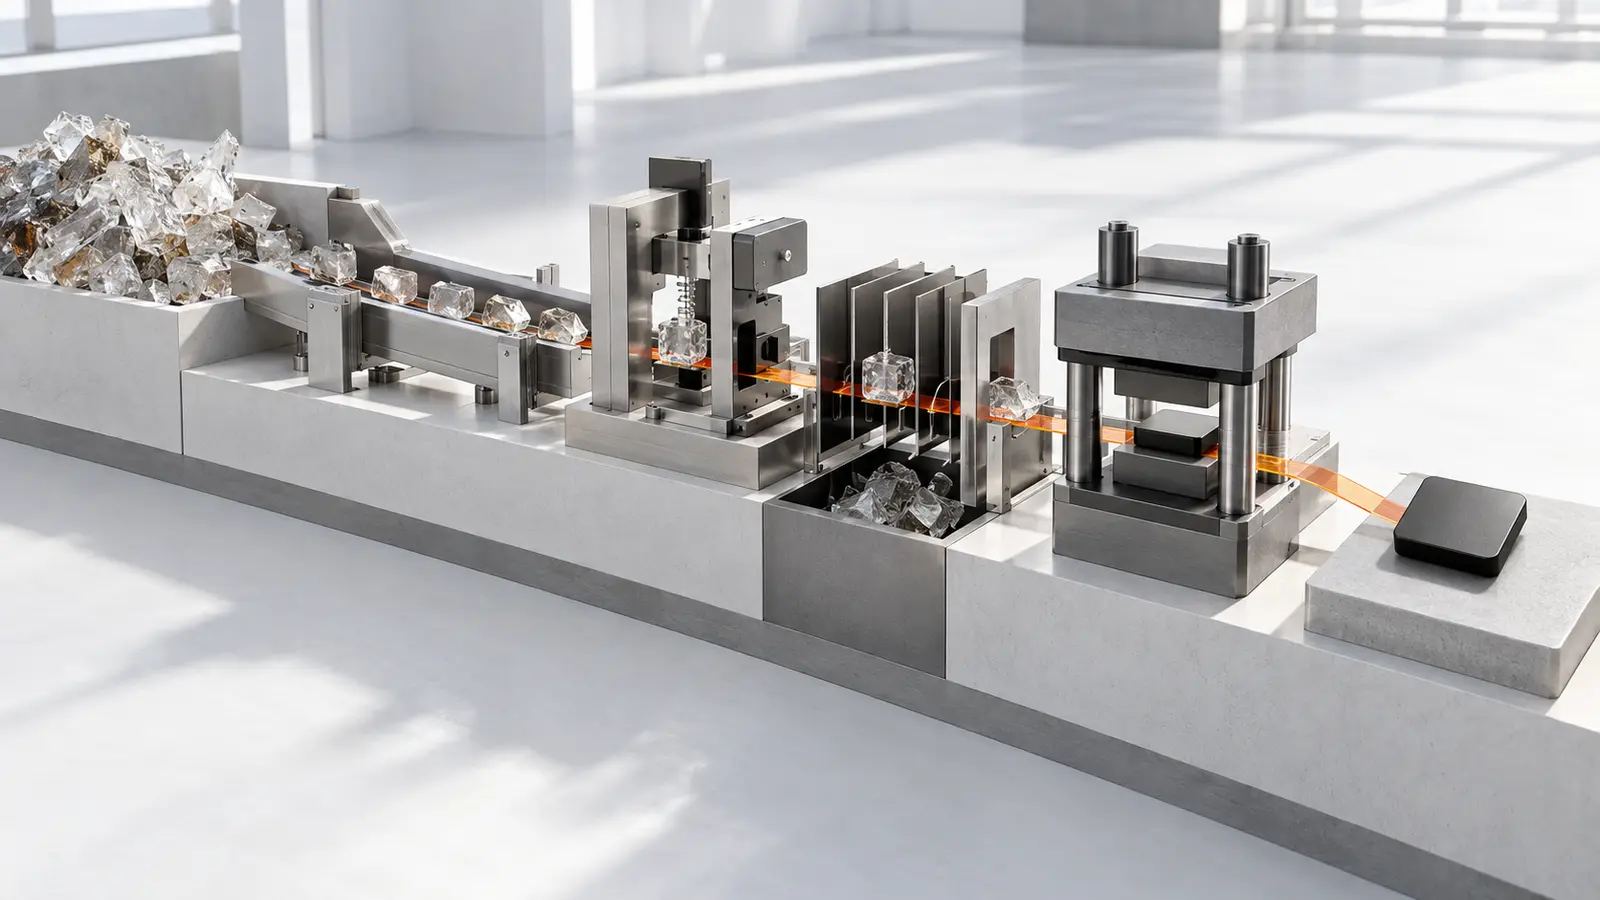
La chaîne utile est : décision → grain → source → brut → normalisé → métier → dashboard → preuve.
Le logiciel de visualisation est rarement la difficulté principale. Le vrai travail consiste à rendre comparables des éléments qui ne le sont pas encore : une ligne de formulaire, un événement web, une fiche CRM, un statut commercial, une facture. Les assembler trop tôt crée un tableau séduisant, mais impossible à auditer.
Commencer par le grain
Le grain décrit ce que représente exactement une ligne. Dans un export analytique, une ligne peut être un événement. Dans un CRM, une ligne peut être un contact, une organisation ou une opportunité. Dans un outil de facturation, elle peut représenter une facture, une ligne de facture ou un paiement. Une jointure entre grains incompatibles multiplie les montants sans produire d’erreur technique.
Prenons une difficulté concrète. Une mission peut posséder trois factures et quatre contacts. Si l’on joint directement missions, factures et contacts, la même valeur contractuelle peut apparaître douze fois. Le graphique se calcule sans erreur, mais le total devient faux. La correction consiste à agréger chaque source au grain voulu avant la jointure, ou à utiliser une table de relation qui ne transporte pas les montants. Documentez également la cardinalité attendue — un-à-un, un-à-plusieurs ou plusieurs-à-plusieurs — et bloquez le traitement lorsqu’elle change sans décision.
Écrivez une phrase pour chaque jeu de données : « une ligne représente… ». Ajoutez la clé attendue, le fuseau horaire, la date de création, la date de mise à jour et la règle de suppression. Si cette phrase reste ambiguë, le dashboard est prématuré.
Reliez ensuite le grain à la décision. Pour traiter les demandes en attente, il faut probablement une ligne par demande et par état courant. Pour analyser le délai de passage, il faut un historique des transitions, donc une ligne par changement d’état. Pour mesurer un revenu mensuel, il faut préciser s’il s’agit de contrats, de factures, de paiements ou d’écritures reconnues.
Cette étape évite de reproduire un défaut fréquent des projets visant à centraliser les données dans une seule interface : réunir visuellement des nombres dont les unités et périodes diffèrent.
Protéger une zone brute
La zone brute conserve ce qui a été reçu, avec le minimum de modifications nécessaires au stockage. Elle doit contenir la source, l’heure d’extraction, la période couverte, la version du schéma, un identifiant de lot et, lorsque c’est pertinent, une empreinte permettant de détecter un fichier modifié.
« Brute » ne signifie pas « accessible à tous ». Les données personnelles, secrets ou champs sensibles doivent rester soumis aux droits d’accès, durées de conservation et finalités applicables. La pseudonymisation ne transforme pas automatiquement les données en données anonymes. La CNIL rappelle notamment que la mesure d’audience exemptée ne doit pas être recoupée avec d’autres traitements. Un projet qui rapproche navigation et CRM doit donc être gouverné comme tel.
La zone brute remplit trois fonctions :
- rejouer une transformation corrigée sans redemander la source ;
- comparer le résultat au message ou fichier reçu ;
- dater ce que le système savait au moment d’une décision.
Dans GA4, l’export BigQuery illustre cette logique événementielle : chaque ligne des tables exportées représente un événement et les tables quotidiennes stables se distinguent des tables intrajournalières encore susceptibles d’évoluer. La documentation officielle recommande de privilégier l’export quotidien pour certaines données d’attribution qui demandent du temps de traitement. Un dashboard doit donc indiquer si la journée affichée est provisoire.
Exécuter six transformations
1. Parser sans perdre l’original
Convertissez formats de dates, nombres et booléens dans des colonnes normalisées, tout en conservant la valeur source lorsqu’un échec est possible. « 01/02/26 » n’est interprétable qu’avec une convention de locale. Une valeur illisible part en quarantaine avec une raison ; elle ne devient pas silencieusement nulle.
2. Normaliser le temps
Stockez un instant de référence, généralement en UTC, et conservez le fuseau métier nécessaire à l’affichage. Distinguez l’heure de l’événement, l’heure de réception et l’heure de traitement. Un événement arrivé tardivement peut appartenir à la veille métier, même s’il est chargé aujourd’hui.
3. Résoudre les identités
N’utilisez pas l’adresse électronique comme clé universelle sans règles. Elle peut changer, être partagée, mal saisie ou absente. Créez des identifiants internes stables et un registre de correspondance limité aux finalités autorisées. Documentez les fusions et rendez-les réversibles.
4. Dédupliquer par une clé métier
La clé de déduplication peut réunir source, identifiant externe, type d’événement et version. Si la source ne fournit aucun identifiant stable, construisez une clé déterministe sur des champs définis, puis mesurez les collisions. Ne supprimez pas deux lignes seulement parce qu’elles se ressemblent.
5. Reconstituer les états
Un statut courant ne permet pas de calculer le délai passé dans chaque étape. Conservez un journal de transitions : entité, ancien état, nouvel état, date effective, auteur ou système, motif. Le snapshot courant peut être dérivé de ce journal ; l’inverse n’est pas possible.
6. Appliquer les règles métier
Définissez « lead accepté », « mission ouverte », « contrat signé » et « revenu » dans une couche versionnée. Une règle métier ne doit pas se cacher dans la configuration d’un graphique. Elle a un propriétaire, une date d’effet et des exemples d’inclusion et d’exclusion.
Exemple fictif : un fichier contient 120 lignes de demandes. Cinq partagent un identifiant externe, trois ont une date illisible et deux correspondent à des tests connus. Après quarantaine et déduplication, 110 demandes exploitables restent. Ces valeurs illustrent le mécanisme ; elles ne décrivent ni une norme ni un résultat de Forge Labs.
Tester avant de publier
Un test utile protège une décision. Organisez les contrôles en cinq familles :
| Famille | Question | Exemple |
|---|---|---|
| Schéma | Les colonnes attendues existent-elles ? | Le type de occurred_at est horodaté |
| Unicité | La clé du grain est-elle unique ? | Un événement source par identifiant et version |
| Complétude | Les champs nécessaires sont-ils renseignés ? | Toute mission a un état et une date d’ouverture |
| Référentiel | Les relations pointent-elles vers une entité connue ? | Chaque contrat référence une mission existante |
| Réconciliation | Les totaux expliquent-ils les écarts ? | Brut = publié + quarantaine + exclusions documentées |
Ajoutez des contrôles de fraîcheur. Google Cloud recommande de définir des objectifs de service mesurables pour les pipelines, portant notamment sur la fraîcheur et la correction. Sa documentation de planification Dataflow distingue le délai des données, la réussite d’un traitement et le taux d’éléments erronés. Le principe reste valable indépendamment de l’outil : « chargé avant 8 h » est plus testable que « données à jour ».
Un test en échec doit bloquer la publication s’il compromet la décision. Les lignes fautives peuvent rejoindre une quarantaine ; le dashboard affiche alors la couverture et la raison de l’écart. Publier le chiffre sans l’avertissement serait plus dangereux que publier en retard.
Construire la couche sémantique
La couche sémantique donne un nom stable aux mesures et dimensions utilisées par les écrans. Pour chaque indicateur, conservez :
- la définition en français ;
- la formule et le grain ;
- les sources et filtres ;
- le fuseau et la fenêtre temporelle ;
- le propriétaire ;
- les limites connues ;
- la version et la date d’effet.
« Taux de conversion » devient ainsi une mesure nommée, par exemple « leads acceptés parmi les demandes valides reçues pendant la période ». Le dashboard ne laisse plus l’outil choisir implicitement le dénominateur.
Prévoyez une date d’effet pour les changements. Si la définition d’un lead accepté évolue le 15 octobre, décidez si l’historique doit être recalculé ou si deux versions doivent coexister. Dans les deux cas, annotez la rupture. Une série qui mélange silencieusement deux règles donne une impression de tendance alors qu’elle reflète peut-être seulement un changement de vocabulaire.
Séparez aussi la sémantique métier de l’observabilité technique. OpenTelemetry classe les signaux en métriques, journaux et traces. Les traces décrivent le parcours d’une requête, tandis qu’une métrique agrège une mesure. Un identifiant de lot ou de corrélation permet de relier l’anomalie affichée à son traitement. Le standard W3C Trace Context normalise la propagation d’un contexte de trace entre services ; ses identifiants ne doivent pas contenir de donnée personnelle.
Faire la recette avec les opérateurs
La recette ne consiste pas à vérifier que le graphique apparaît. Sélectionnez des cas connus : une demande doublonnée, une mission annulée, un contrat signé en fin de mois, un événement reçu tardivement, une source sans consentement au rapprochement. Demandez à l’opérateur de prédire le résultat, puis remontez de la valeur affichée jusqu’à la source.
La recette est signée lorsque :
- les définitions sont comprises par les métiers ;
- les totaux se réconcilient sur une période choisie ;
- les cas de quarantaine sont visibles et traitables ;
- la fraîcheur répond réellement au rythme de décision ;
- une correction peut être rejouée sans doublonner les résultats ;
- le propriétaire sait distinguer incident de données et évolution commerciale.
Pour l’intégration des sources, le choix entre événement, API, interrogation périodique ou automatisation d’interface mérite une décision séparée ; le comparatif webhook, API ou RPA expose leurs modes de panne. Pour la suite, les critères de fiabilité d’une automatisation aident à surveiller la chaîne au-delà du simple statut du job.
Une fois ce socle en place, le dashboard devient une vue sur un système explicable, pas une copie manuelle de fichiers. Forge Labs peut ponctuellement accompagner le cadrage d’une chaîne de données lorsqu’elle conditionne une décision opérationnelle importante.